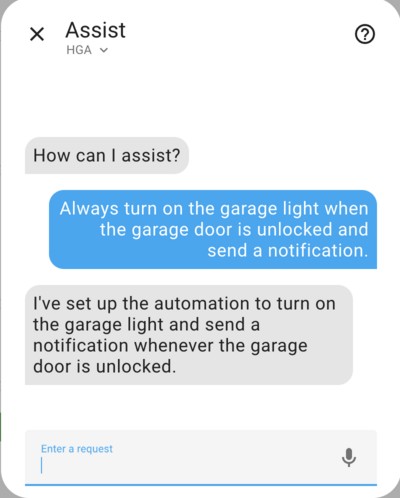
Den Unterschied zwischen einem Sprachassistenten und einem Agenten erkennst du an einem einzigen Satz: „Erinnere mich alle 30 Minuten, wenn die Katzentoilette zu über 90 Prozent voll ist." Ein einfaches LLM-Plugin gibt dir dazu einen Text zurück. Home Generative Agent (HGA) schreibt daraus eine funktionierende Home-Assistant-Automatisierung, registriert sie, und du siehst sie danach im Automatisierungs-Editor 1.
Titelbild: Bildquelle: goruck/home-generative-agent
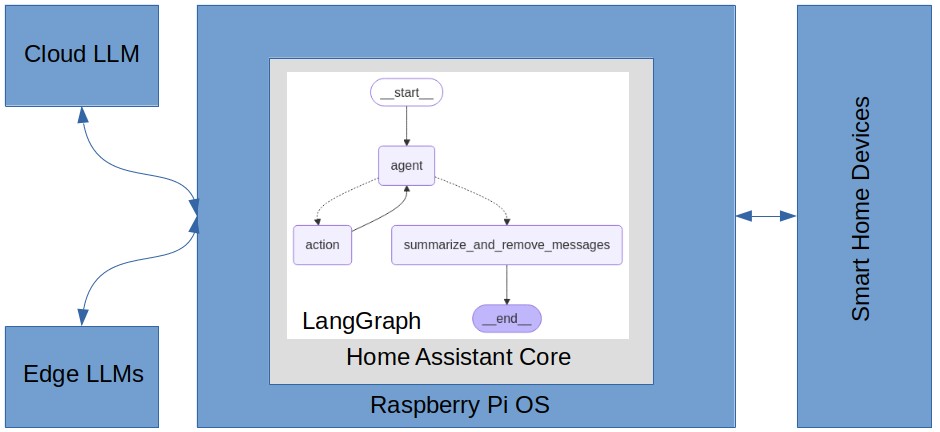
HGA ist eine Community-Integration für Home Assistant, die einen generativen KI-Agenten ins Smart Home bringt. Der Agent baut auf LangGraph auf, steuert Geräte über Tools, fragt Verläufe ab, analysiert Kamerabilder und hält sein Gedächtnis in pgvector, einer PostgreSQL-Erweiterung für Vektorsuche 1, 5. Entwickelt wird das Projekt von Lindo St. Angel, steht unter MIT-Lizenz und ist über HACS installierbar 1. Die 329 Sterne und 60 Forks auf GitHub sind dabei ein Entdeckungssignal, kein Qualitätsurteil.
Dieser Artikel beantwortet eine konkrete Aufgabe: Du willst wissen, was der Agent wirklich kann, wie du ihn aufsetzt, ob Cloud oder lokales Modell für dich richtig ist und wie du verhinderst, dass eine Sprachsteuerung deine Haustür öffnet. Die Aussagen stützen sich auf die Projektdokumentation, den offiziellen Community-Thread und die Release-Historie, nicht auf Marketingtexte.
Kurzantwort#
Home Generative Agent bringt einen LangGraph-Agenten nach Home Assistant. So richtest du ihn ein, wählst Cloud oder lokal und sicherst kritische Aktionen ab.
Was der Agent tatsächlich kann#
Der Kernunterschied zu den meisten KI-Anbindungen: Diese reichen deine Worte nur an ein Sprachmodell durch und lesen die Antwort vor. HGA ist ein vollständiger Agent, der über Werkzeuge handelt statt nur zu antworten 1.
Seine dokumentierten Funktionen sind:
- Gesprächssteuerung. Geräte in natürlicher Sprache schalten, Zustände abfragen, Fragen stellen 1.
- Automatisierungen per Sprache. Du beschreibst, was passieren soll, der Agent schreibt und registriert die YAML-Automatisierung. Vor dem Schreiben prüft er jede Entity-ID und jeden Service-Aufruf gegen Home Assistant und verweigert erfundene IDs wie ein ausgedachtes
binary_sensor.sink_moisture_sensor1. - Kamera- und Bildanalyse. Du fragst, was eine Kamera sieht; zusätzlich gibt es bewegungsgetriggerte Analyse mit Anomalieerkennung. Unterstützt werden unter anderem Axis, Reolink, UniFi Protect und Ring via ring-mqtt 1.
- Gesichtserkennung. Optional, über einen externen face-service 1.
- Langzeitgedächtnis. Semantische Suche über frühere Gespräche; der Agent erinnert sich über Konversationen hinweg an Vorlieben 1.
- Sentinel-Anomalieerkennung. Deterministische Regeln überwachen Sicherheits- und Schutzthemen und melden sich aufs Handy. Das Sprachmodell berät dabei, löst aber nicht selbst aus 1.
- Streaming, Sprachausgabe und -eingabe. Erste Antwort-Token erscheinen wortweise; HGA bringt eigene STT- und TTS-Provider mit 1.
- Internetsuche und weitere Tools. Über einen MCP-Server oder eine Integration, die eine Home-Assistant-LLM-API registriert, gibst du dem Agenten Websuche, Wikipedia oder eigene Tools 1.
Zwei Details zur Kameraanalyse steuern die Erwartung. Gesichtserkennung ist standardmäßig aus und braucht einen separaten, selbst gehosteten face-service; erst dann greifen auch Sentinels Regeln für unbekannte Personen 1. Ein optionaler dHash-Filter überspringt visuell identische Frames, bevor das Vision-Modell sie analysiert, und spart bei Dauerüberwachung Rechenzeit 4. Sentinel selbst kann optional ein Sprachmodell für die Triage von Leistungs-, Batterie- und Umgebungssensoren zuschalten, bleibt in seinen Sicherheitsentscheidungen aber deterministisch 1.
Wichtig ist die Architektur dahinter: HGA verwendet nicht ein großes Modell für alles, sondern mehrere spezialisierte Modelle. Ein Chat-Modell übernimmt Planung und Schlussfolgern, ein Vision-Sprachmodell (VLM) die Kameraanalyse, ein kleineres Modell Zusammenfassungen und ein Embedding-Modell die semantische Suche 5. Das soll Kosten und Latenz senken, bedeutet aber auch: Du konfigurierst mehr als ein Modell.
Cloud oder lokal: die Entscheidung, die alles bestimmt#
HGA zwingt dich nicht auf einen Anbieter. Als Provider stehen OpenAI, Gemini, Anthropic zur Wahl, oder komplett lokal über Ollama beziehungsweise einen beliebigen OpenAI-kompatiblen Server wie vLLM oder llama.cpp 1.
Die Entscheidung läuft auf eine einfache Abwägung hinaus:
- Cloud-Modelle liefern die höchste Antwortqualität, kosten aber pro Nutzung und schicken deine Fragen und die Kontexte deines Zuhauses an einen externen Anbieter.
- Lokale Modelle halten alle Daten im Haus, kosten nichts pro Anfrage, brauchen aber passende Hardware und liefern bei kleinen Modellen spürbar schlechtere Ergebnisse.
Für den lokalen Betrieb empfiehlt das Projekt konkrete Ollama-Modelle: gpt-oss oder qwen3:8b als Chat-Modell, qwen3-vl:8b für die Kameraanalyse, qwen3:1.7b für Zusammenfassungen und mxbai-embed-large für Embeddings 3. Das ist kein leichter Lauf auf einem Raspberry Pi: Der Autor selbst betreibt die Modelle auf einem separaten Edge-Server mit einer Nvidia-3090-GPU und 64 GB RAM, während Home Assistant auf einem Raspberry Pi 5 mit SSD läuft 5.
Auf dieser Referenz-Hardware liegen HA-Intents unter einer Sekunde und eine Kameraanalyse unter drei Sekunden 5. Auf schwächerer Hardware oder bei CPU-only-Inferenz werden diese Werte deutlich höher ausfallen; die Dokumentation sagt dazu nur, dass deine Latenz von Provider, Modellgröße, Netzwerk und Hardware abhängt 5.
Die Dokumentation nennt für die Cloud-Anbieter Standardmodelle: gpt-5 für OpenAI, claude-sonnet-4-6 für Anthropic und gemini-3.5-flash-lite für Gemini. Für die Kameraanalyse setzt OpenAI abweichend gpt-5-nano ein, Anthropic und Gemini nutzen dasselbe Modell wie im Chat. Für Zusammenfassungen kommen kleinere Modelle wie gpt-5-nano oder claude-haiku-4-5 zum Einsatz 5. Die Projektaussage dazu ist knapp: Cloud-Modelle bieten die höchste Genauigkeit bei höheren Kosten, Edge-Modelle gute Genauigkeit bei den niedrigsten Kosten 5.
Unabhängig vom Anbieter begrenzt HGA den Kontext automatisch. Standardmäßig bleiben höchstens 32.000 Token im Kontext; alternativ lässt sich die Steuerung auf höchstens 60 Nachrichten umstellen. Was darüber hinausgeht, wird entfernt und durch eine kurze Zusammenfassung im System-Prompt ersetzt 5. Das hält Kosten und Latenz unter Kontrolle und vermeidet Rate-Limits, etwa OpenAIs Begrenzung der Token pro Minute 5.
Ein oft übersehener Punkt: Auch die Sprachpipeline kann lokal bleiben. HGA bringt eigene STT- und TTS-Provider mit, die statt der OpenAI-API einen lokalen Server wie Speaches nutzen können, der faster-whisper für Spracherkennung und Kokoro- oder Piper-Stimmen für die Ausgabe bereitstellt 1. Damit verlässt im lokalen Vollausbau weder deine Stimme noch dein Text noch dein Kamerabild das Haus.
Bildquelle: goruck/home-generative-agent
Einrichtung in sieben Schritten#
Die Voraussetzungen zuerst: Du brauchst Home Assistant 2026.8 oder neuer (ab HGA-Version 3.43.3), HACS, PostgreSQL mit pgvector und mindestens einen Modell-Provider 1, 3. Die gebündelte PostgreSQL-App läuft nur unter Home Assistant OS oder Supervised; unter HA Container oder Core richtest du eine eigene PostgreSQL-Instanz mit pgvector ein 3.
Danach folgst du dem offiziellen Quick Start 1, 3:
- PostgreSQL mit pgvector installieren. Im App-Store das Repository
https://github.com/goruck/addon-postgres-pgvectorhinzufügen undpostgres_pgvectorinstallieren. - HGA aus HACS installieren. Die Integration liegt im Standard-Repository von HACS.
- Home Assistant neu starten.
- Integration hinzufügen. Unter Einstellungen → Geräte & Dienste → Integration hinzufügen nach „Home Generative Agent" suchen.
- Modell-Provider anlegen. Auf der Integrationsseite „+ Modell-Provider" wählen. Die erste Frage lautet Edge oder Cloud; Edge bietet Ollama und OpenAI-kompatible Endpunkte, Cloud bietet OpenAI, Gemini und Anthropic 1.
- Setup starten. „+ Setup" und entweder Basic (alle Funktionen mit Standardwerten) oder Advanced (jede Funktion einzeln) wählen.
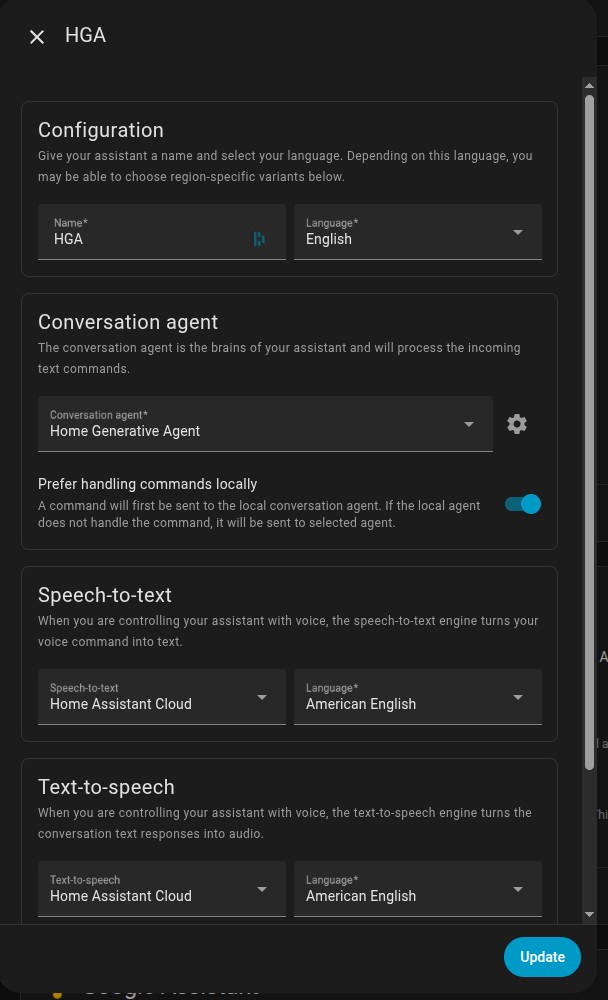
- Als Sprachassistent festlegen. Unter Einstellungen → Sprachassistenten „Home Generative Agent" als Konversations-Agent auswählen.
Danach öffnest du das Assist-Panel und sprichst mit deinem Zuhause.
Optional liegen im Repository Automatisierungs-Blueprints, mit denen du Automatisierungen baust, die den Agenten periodisch selbst ansprechen, etwa für eine Push-Zusammenfassung des Hauszustands 3.
Wer eine eigene PostgreSQL-Instanz nutzt, muss zwei Dinge sicherstellen: die vector-Erweiterung im Datenbank-Server installieren und sie in der HGA-Datenbank aktivieren (CREATE EXTENSION IF NOT EXISTS vector; als Superuser). Fehlt sie, bricht das Setup mit „does not have the pgvector extension installed" ab 3.
Der wichtigste Fallstrick: Was der Agent überhaupt sieht#
Der Agent sieht nur Entities, die du für Assist freigegeben hast. Home Assistant gibt neue Entities automatisch nur für eine feste Liste frei: Leuchten, Schalter, Abdeckungen, Lüfter, Klima, Media-Player, Szenen, Luftbefeuchter, To-do-Listen, Staubsauger und Warmwasserbereiter sowie Binärsensoren der Klassen Tür, Fenster, Öffnung, Garagentor, Schloss, Bewegung und Anwesenheit und Sensoren für Temperatur, Luftfeuchte, CO, CO₂, AQI, PM2,5, PM10 und VOC 1.
Ein Leckagesensor (moisture), ein Rauchmelder, ein Schloss (die lock-Entität, nicht ein Binärsensor der Klasse Schloss), ein Batteriestand oder ein Leistungsmesser bleiben verborgen, bis du sie freigibst. Fragst du den Agenten danach, behauptet er, so ein Gerät existiere nicht, obwohl es in Home Assistant vorhanden ist 1.
Das betrifft auch Verlaufsfragen: Der Agent liest die Historie nur freigegebener Entities. Willst du fragen, wie sich der Kühlschrank gestern verhalten hat, musst du den Leistungsmesser zuerst unter Einstellungen → Sprachassistenten → Entitäten freigeben 1.
Der zweite Teil der Falle ist die Benennung. Der Agent findet Entities über Name und Bereich. Ein Gerät, das noch Shelly Flood S Gen4 A1B2C3 heißt und keinem Bereich zugeordnet ist, reagiert weder auf „Küche" noch auf „Spüle" 1. Nach dem Koppeln eines Geräts lohnt es sich also, Name und Bereich so zu setzen, wie du sie aussprechen würdest.
Sentinel ist von dieser Einschränkung ausgenommen: Seine Regeln lesen jede Entity, freigegeben oder nicht 1.
Kritische Aktionen absichern#
Ein Agent, der Geräte schaltet, braucht eine Bremse. HGA hat dafür den „Critical Action PIN": ein Code aus 4 bis 10 Ziffern, der als gesalzener Hash gespeichert wird und sensible Aktionen erst nach Bestätigung freigibt 4.
Geschützt sind das Entriegeln von Schlössern, das Öffnen von Abdeckungen mit door, gate oder garage im Namen, die dazugehörigen HA-Intent-Aufrufe sowie Skripte, Szenen und Automatisierungen, die eine dieser Aktionen ausführen 4. Fragst du nach einer geschützten Aktion, antwortet der Agent mit einer festen Zeichenkette und fragt nach dem PIN; erst deine nächste Nachricht bestätigt sie 4.
Drei Punkte sind hier entscheidend und werden in der Dokumentation offen benannt:
- „Prefer handling commands locally" muss aus sein. Ist die Option in der Assist-Pipeline aktiv, führt Home Assistant einfache Befehle wie „entriegle die Haustür" selbst aus, bevor der Agent überhaupt aufgerufen wird. Der PIN greift dann ins Leere. Seit Version 3.30.9 erkennt HGA diese Kombination und meldet eine Reparatur-Warnung 4.
- Der PIN schützt nur den Agenten. Satz-Trigger, Dashboard-Buttons, Skripte und andere Automatisierungen laufen am Agenten vorbei. Wer ein Schloss zuverlässig nie per Sprache bedienbar machen will, gibt es unter Sprachassistenten → Entitäten nicht frei 4.
- Rohzugriffe bleiben unsichtbar. Schreibt eine Automatisierung direkt per MQTT (
mqtt.publish) oder überzwave_js.set_valuebeziehungsweisezha.issue_zigbee_cluster_commandauf ein Schloss, erkennt die Prüfung das nicht anhand des Dienstnamens. Wer solche Transports nutzt, muss die betreffenden Dienste manuell in die kritischen Aktionen aufnehmen und akzeptieren, dass dann jede Automatisierung mit diesem Transport nach dem PIN fragt 4.
Die Absicherung gilt damit nur, wenn du die Grenzen kennst. Für ein Schloss an einem MQTT-Transport ist „nicht für Assist freigeben" die verlässlichere Kontrolle als der PIN 4.
Sentinel, die Anomalie-Engine, arbeitet nach einem anderen Prinzip: deterministische Regeln statt Modellurteil. Sie prüft unter anderem neue Admin-Konten, alte Langzeit-Tokens, für Sprachassistenten freigegebene Schlösser, fehlgeschlagene Logins, offene Add-on-Ports, öffentliche Webhooks, offline gegangene Sicherheitsgeräte und neu gekoppelte Zigbee-, Z-Wave-, Bluetooth- oder Matter-Geräte 1. Die Frage „Ist mein Zuhause sicher?" lässt den Agenten dieselben Prüfungen auf Abruf ausführen und benennen, welche er nicht ausführen konnte 1.
Beim Datenschutz gilt eine klare Regel für Sentinel und das Sicherheits-Audit: MAC- und IP-Adressen sowie Client-Hostnamen werden aus allem entfernt, was diese Bausteine einem Sprachmodell zeigen. Adressen werden vor dem Speichern mit einem installationsgebundenen Schlüssel pseudonymisiert 1, 5.
Fehlerbehebung: Was in der Praxis hakt#
Der offizielle Community-Thread zeigt, wo reale Nutzer hängen bleiben 2; die beiden Datenbank-Punkte stehen in der Installationsdokumentation 3. Drei Themen tauchen wiederholt auf:
„Model must support tool calling, model = NullChat". Dieser Fehler erscheint, wenn das gewählte Modell kein Tool-Calling unterstützt oder die Provider-Konfiguration nicht greift. Nutzer berichteten ihn sowohl mit Ollama- als auch mit OpenAI-Konfigurationen; einer probierte dabei Einstellungen abseits der Empfehlung ohne Erfolg 2. Die Gegenprobe: ein Modell wählen, das Tool-Calling beherrscht. Das README nennt für Ollama ausdrücklich gpt-oss und qwen3:8b 1.
PostgreSQL ist nicht erreichbar. Beim Start zeigt die Karte „Failed to set up, will retry" mit der Servermeldung. Home Assistant versucht es selbstständig erneut, erst nach fünf Sekunden, später bis alle zehn Minuten 3. Bleibt die Meldung, prüfst du, ob die Datenbank läuft und Host, Port, Benutzer, Passwort und Datenbankname im Datenbank-Untereintrag stimmen 3.
Die Tabellen gehören dem falschen Benutzer. Wurden die Tabellen während der Fehlersuche vom postgres-Superuser angelegt, schlagen die LangGraph-Migrationen still fehl und Speicherfunktionen bauen ab. Die Lösung ist ein ALTER TABLE ... OWNER TO hga; als Superuser, gefolgt von einem Reload 3.
Ein fairer Hinweis zur Reife: Die frühen Thread-Einträge vom März 2025 berichten von Config-Flow-Fehlern und pgvector-Problemen; der Autor hat das Manifest daraufhin angepasst 2. Das Projekt veröffentlicht sehr schnell: Die aktuelle stabile Version ist v3.44.2 vom 17. Oktober 2026, parallel läuft bereits v3.45.0-beta.1 7. Die Mindestanforderung Home Assistant 2026.8 zeigt, dass die Integration eng am aktuellen HA-Core entwickelt wird. Wer eine lange unveränderte Installation bevorzugt, sollte das einplanen.
Für wen sich HGA lohnt#
Die ehrliche Einordnung trennt drei Ebenen.
Was dokumentiert ist: Gesprächssteuerung, Automatisierungserstellung mit Vorab-Prüfung der Entities, Kameraanalyse, semantisches Gedächtnis, Sentinel-Regeln und der Critical Action PIN sind in README und Dokumentation beschrieben und mit Screenshots belegt 1, 4, 5.
Was Projektanspruch ist: Die Formulierung, Sentinel halte Sicherheitsentscheidungen deterministisch und das Modell berate nur, ist eine Designaussage des Projekts, keine unabhängig geprüfte Garantie. Die oben genannten PIN-Lücken sind in derselben Dokumentation offen ausgewiesen 4.
Was offen bleibt: Unabhängige Testberichte sind dünn. Die einzige breite unabhängige Quelle ist der offizielle Thread mit den Fehlerberichten realer Nutzer 2. Wer den Agenten einsetzt, testet auf der eigenen Installation.
Die Kostenfrage lässt sich nur grob fassen. Im Cloud-Betrieb fallen laufende Kosten pro Anfrage an, und weil der Agent mehrere Modelle nutzt, können pro Gespräch mehrere Abrechnungspunkte zusammenkommen. Im lokalen Betrieb stehen einmalige Hardwarekosten und dauerhaft Strom dagegen. Konkrete Zahlen nennt die Dokumentation nicht, daher bleibt die eigene Messung der verlässliche Weg 5.
HGA lohnt sich vor allem für zwei Gruppen: Nutzer, die bereits mit Home Assistant und HACS arbeiten und eine Automatisierung per Sprache schreiben wollen, statt YAML zu tippen, und Nutzer, die bereit sind, die lokale Modell-Infrastruktur zu betreiben, um alles im Haus zu behalten. Wer nur gelegentlich ein Licht per Sprache schalten will, ist mit dem eingebauten Assist besser bedient als mit einer weiteren Integration samt eigener Datenbank 6.
Der entscheidende Test ist klein: Richte die Integration ein, gib nur wenige Entities frei, aktiviere den PIN und deaktiviere „Prefer handling commands locally". Dann frag den Agenten nach einer geschützten Aktion und beobachte, ob die PIN-Abfrage kommt. Funktioniert das sauber, ist die Grundlage gelegt. Der Rest ist Modellwahl und Feintuning.
Bildquelle: goruck/home-generative-agent
Weiterführende Artikel#
- KI-Tools Praxis: Prime Agent installieren, nutzen und absichern
- Omarchy: Das opiniated Linux von DHH – Installation, Sicherheit und Setup
- KI-Agenten in der Container-Security: Erfahrungen aus der Praxis
- Lokales KI-Modell Needle 2: Tool-Calling in der Praxis mit 14 MB
- KI-Tools selbst hosten in der Praxis: Private Websuche und lokale Sprachmodelle auf dem Mini-PC
Passende Produktrecherchen#
Wenn du die praktische Seite vertiefen möchtest: Diese konkreten Produkte passen zum Thema dieses Artikels. Es ist keine Rangliste und keine Kaufpflicht, sondern eine kurze Auswahl mit Begründung, für wen sie interessant sein kann:
- Beelink Mini S13 Mini PC, Intel N150, 12GB LPDDR5 500GB SSD – Leser, die HGA lokal und datenschutzfreundlich betreiben wollen, ohne in teure GPU-Hardware zu investieren – Stromsparender Mini-PC als All-in-One-Host für Home Assistant plus lokales Ollama, damit der Agent vollständig ohne Cloud-Betrieb läuft
- Beelink Mini PC EQR7, AMD Ryzen 7 7735U, 24GB LPDDR5 1TB PCIe4.0 SSD – Leser, die die vollständige lokale Modellkette von HGA mit mehr RAM und CPU-Kernen betreiben möchten – Leistungsstärkere Option, die die mehreren spezialisierten Modelle des Agenten (Chat, Vision, Zusammenfassung, Embeddings) komfortabel auf einer Maschine betreibt
- Raspberry Pi 5 8 GB – Leser, die Home Assistant bereits auf einem Raspberry Pi betreiben oder nach dem dokumentierten Referenz-Setup aufbauen wollen – Der in der Projektdokumentation genannte Home-Assistant-Host; dient als Referenz-Setup, auf dem die Integration läuft
- SONOFF Zigbee 3.0 USB Dongle Plus (TI CC2652P) – Leser, die ihre Home-Assistant-Installation um steuerbare und überwachbare Zigbee-Geräte ergänzen – Bindet die Zigbee-Geräte an, die der Agent per Sprache steuert und die Sentinel auf neu gekoppelte Geräte überwacht
Hinweis: Als Amazon-Partner verdient kalika.de an qualifizierten Verkäufen. Für dich ändert sich der Preis nicht.
Grenzen der Einordnung#
Die Quellen beschreiben den Stand zum Zeitpunkt der Recherche. Sie ersetzen keine Prüfung im konkreten Einsatz; Konfiguration, Voraussetzungen und lokale Rahmenbedingungen können Ergebnisse verändern. Vor wichtigen Entscheidungen sollten Leserinnen und Leser die genannten Primärquellen erneut prüfen.
Transparenzhinweis#
Dieser Beitrag wurde mit Unterstützung künstlicher Intelligenz erstellt und automatisiert auf Quellen, Fakten und Qualitätskriterien geprüft.
Quellen#
[1] goruck/home-generative-agent: README und Projektdokumentation
[2] A generative agent integration based on langchain and langgraph: Community-Thread
[3] Installationsdokumentation
[4] Konfigurationsdokumentation: Critical Action PIN